把关键逻辑搬进 C++,编译成 so,确实能增加逆向门槛。但代码搬过去以后,发布包里还剩多少可用线索,仍要检查。
前面聊 SO 加固强度,提到过符号、字符串和加载链。这次往前退一步:为什么已经变成机器码,还需要保护?
分析者通常带着目标来。找到资源解密入口,弄清授权判断,未必需要读完整个库。能把范围缩到几个函数,就足以继续研究。
符号裁剪之后,还剩哪些入口
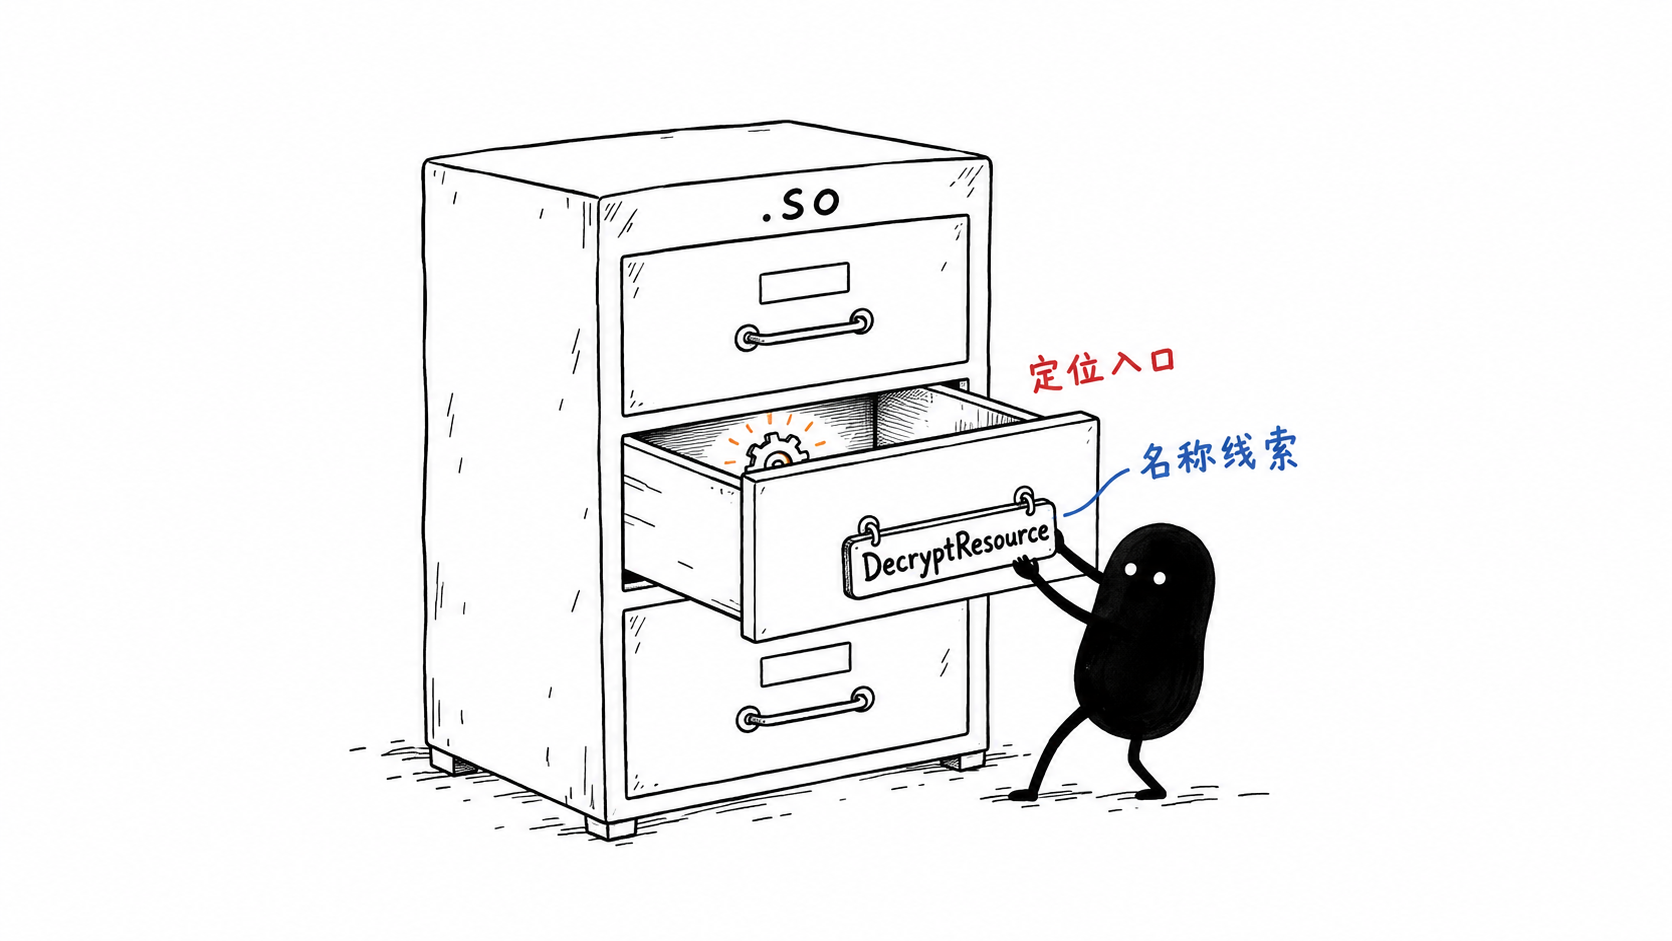
导出符号通常是最先能看出问题的地方。假设库里有个 DecryptResource,还没读机器码,就有了大致的分析方向。C++ 那些很长的修饰名称也类似,用 c++filt 处理后,类名和参数信息可能重新变得可读。
所以,看到“已经做过 strip”,还得确认具体处理了什么。仅移除调试信息,与裁剪普通符号表,处理范围不同;动态链接所需的符号也可能保留。
接着看 .dynsym:哪些是导入,哪些是已经定义、对外可见的函数?只在内部调用的业务函数,有没有也跟着导出?这类名称留在发布包里,相当于替分析者标出了几个值得继续看的位置。
对于通过 RegisterNatives() 注册方法、没有其他导出需求的 JNI 库,可以先用 version script 收敛入口。比如这份 exports.map:
{
    global: JNI_OnLoad;
    local: *;
};
假设 CMake 目标名为 game,清单与当前 CMakeLists.txt 同目录:
set(so_exports "${CMAKE_CURRENT_SOURCE_DIR}/exports.map")
target_link_options(game PRIVATE
    "-Wl,--version-script=${so_exports}"
    "-Wl,--no-undefined-version"
)
set_property(TARGET game APPEND PROPERTY LINK_DEPENDS "${so_exports}")
最后一行让清单修改能触发重新链接。按名称查找的 Java_... 方法和其他跨库接口,仍需纳入清单,并回归实际调用。
导出收敛之后,还可以沿调用关系继续看。名称隐藏了,机器码通常还在。原来能直接认出的函数,现在需要多花多少工夫才能找到,才是这一步值得比较的效果。
字符串能补回业务语义
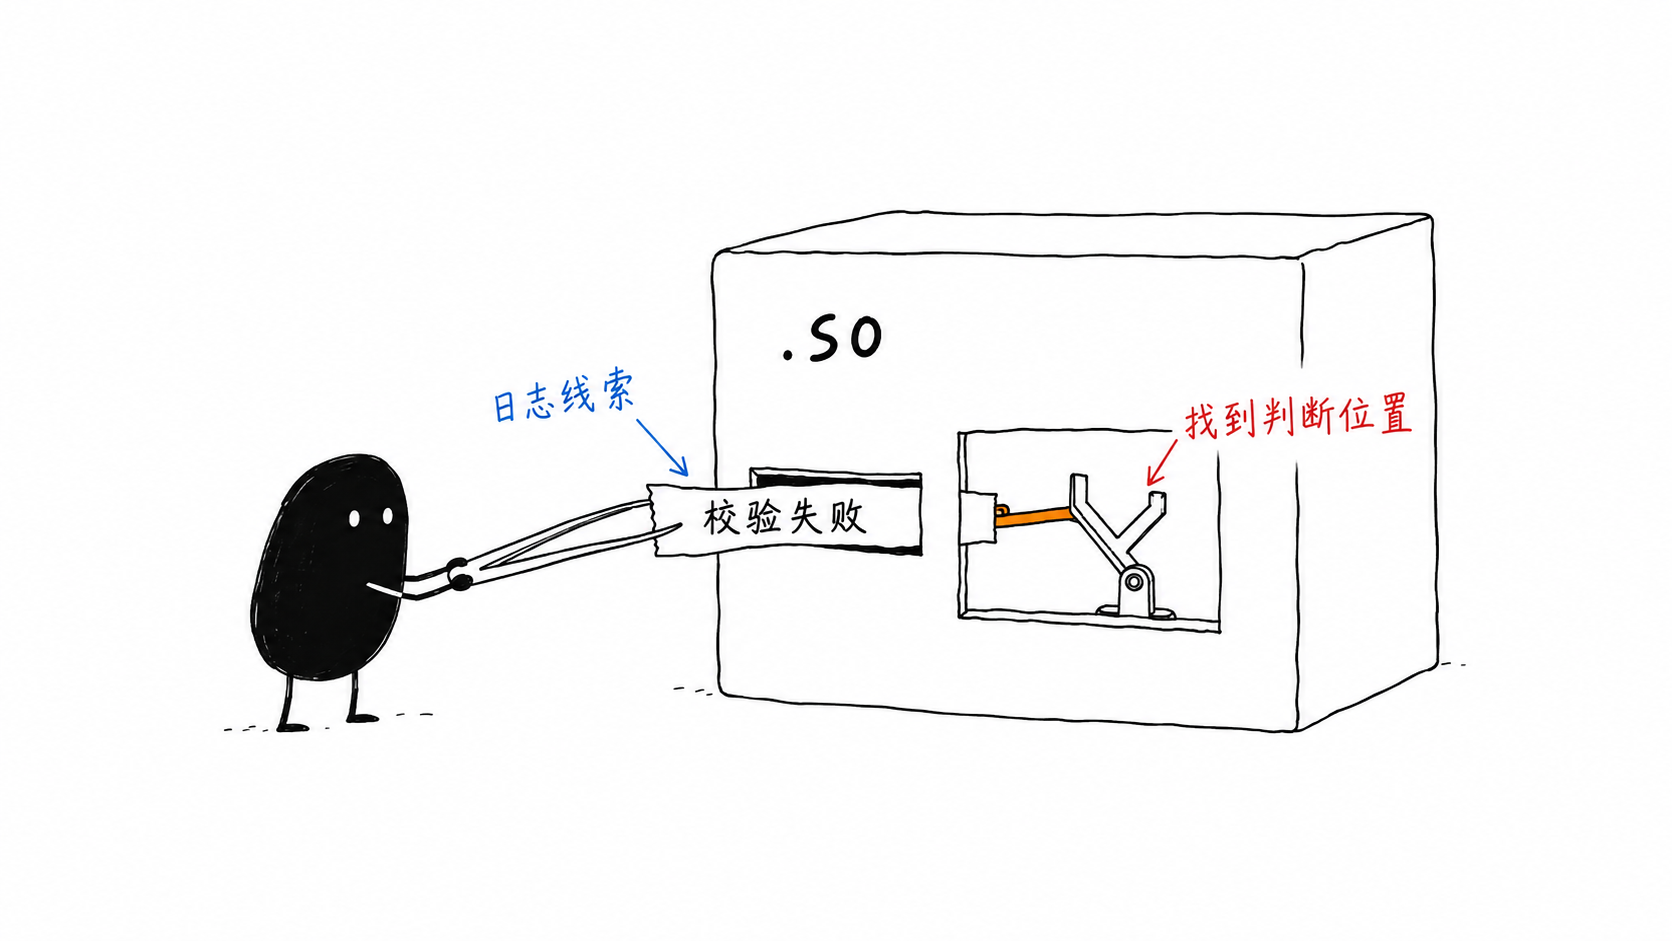
符号裁剪了,日志却可能把用途交代得很清楚。一条 signature failed,就可能把范围缩到校验失败的分支;资源路径、配置字段也能补上业务线索。
这些内容用 strings 就能先扫一遍,不必等整个库反编译完。比起统计多少行字符串,更有用的是挑出那些能直接指向敏感流程的内容。
处理时可以先清掉发布版不需要的详细日志,再看哪些字符串值得额外保护。普通界面提示和解密流程里的内部路径,不必投入同样的精力。
字符串加密也要往后多看一步。如果启动时整表解密,又长期缓存在内存里,分析者换到运行时仍可能拿到明文。它什么时候恢复、保留多久,会影响这层处理实际增加了多少分析成本。
对方可能只需要看懂一小段
下面是资源校验的简化示意,省略类型和底层实现:
bool CanLoadBundle(const BundleInfo& bundle) {
    if (!VerifyBundleSignature(bundle)) {
        LOGE("bundle signature failed: %s", bundle.path.c_str());
        return false;
    }
    return true;
}
名称、日志都在说明用途。即使名称被裁剪,条件分支与返回值的关系仍可能反映在机器码中,具体形态受编译优化影响。
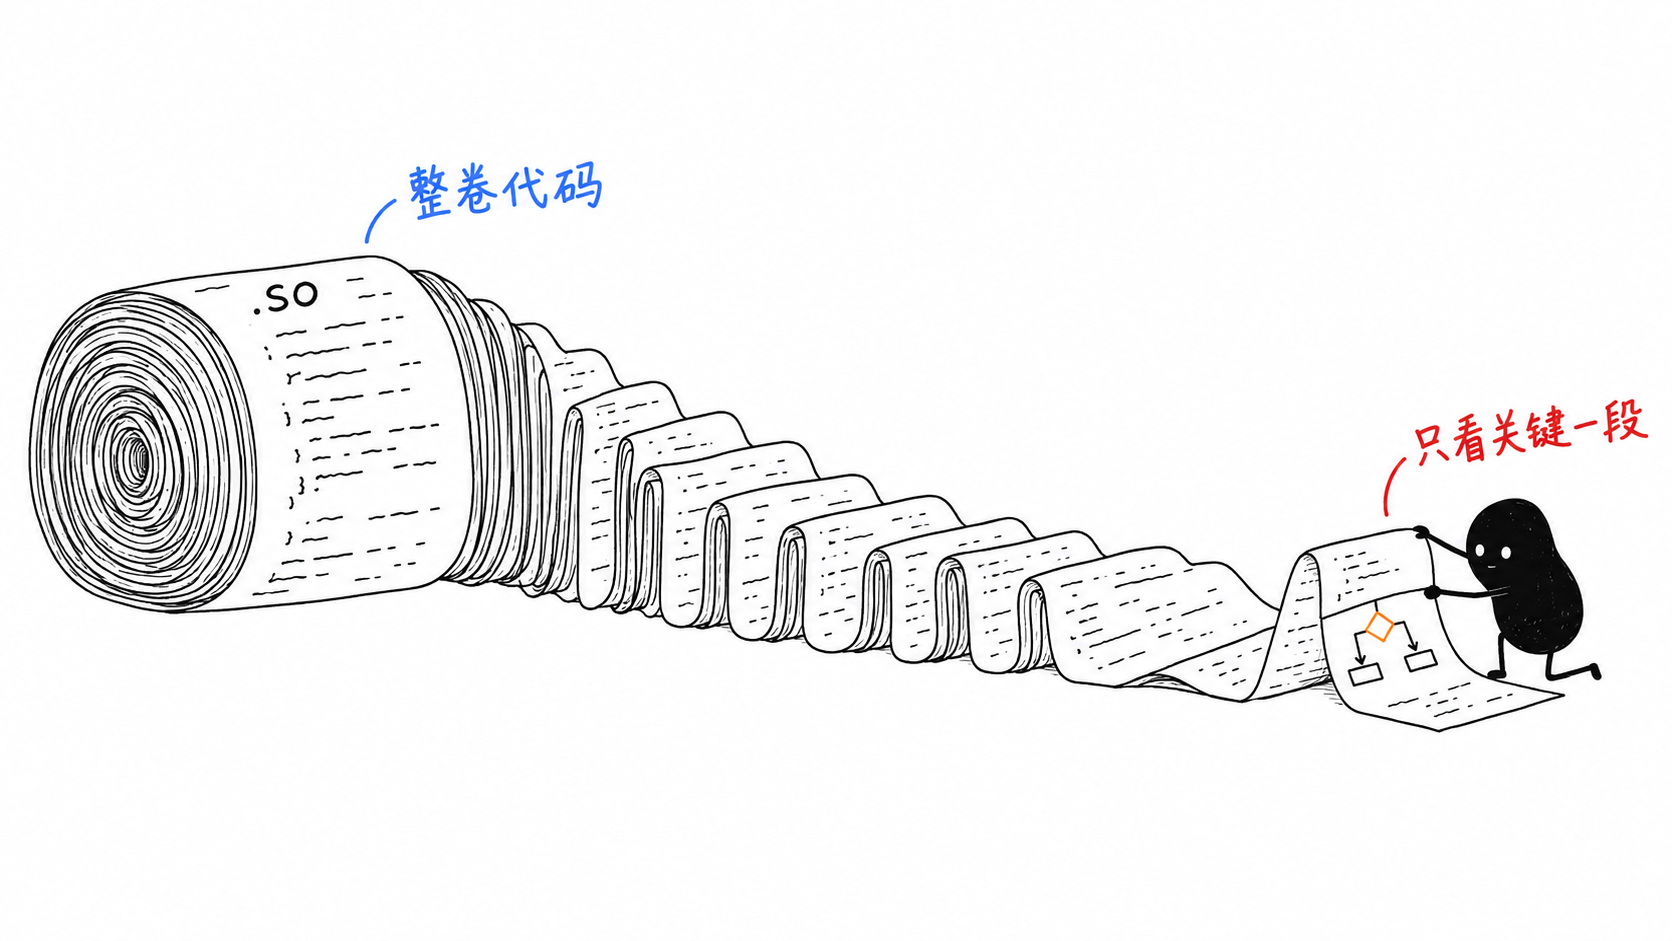
Ghidra 等工具可以辅助反汇编和反编译。结果未必能恢复原始源码,但可能足以分析局部判断。授权检查、资源解密,都有类似问题。
对方关心的可能只是结果从哪里返回,失败后是否继续执行。资源解密则可能只需确认输入、输出和调用位置。其余模块再复杂,也未必增加这条路径的分析成本。
Native 混淆可以针对核心函数增加控制流、指令和数据关系的分析难度。不过,反编译结果难读,不能直接证明逻辑无法理解,或运行时修改会被拦截。
保护要落到最终交付的库里
每帧执行的战斗计算,与登录时的一次授权检查,对开销的容忍度不同。资源解密还要考虑加载频率和场景切换。C++ 代码保护应按业务价值与调用场景选范围,再验证性能和稳定性。
先圈出高价值函数,收敛导出和明文线索,再决定混淆强度,投入更容易落到实处。所有代码都采用同样的处理,性能和维护负担很容易跟着上来。
检查对象也要选对:从最终发布包提取各个 ABI 的库,再看符号和字符串:
readelf --dyn-syms -W libgame.so | c++filt
strings -a -t x libgame.so | rg -i 'signature|reward|decrypt|\.json'
这里使用 GNU Binutils 和 ripgrep。关键词要换成项目自己的日志和字段;编码、拆分或运行时生成都会影响结果。没有匹配不能说明没有暴露,输出的文件偏移也不能直接当作运行时地址。
发布前可以用下面这张表逐项核对,留下对应结果,后续发版也方便比较。
| 检查项 | 核对内容 | 建议留存的依据 |
|---|---|---|
| 发布产物 | 检查最终包内各 ABI 的实际 so | 包版本、文件哈希 |
| 符号导出 | 是否只保留必要接口,JNI 与跨库调用是否正常 | 导出清单、调用回归结果 |
| 字符串 | 日志、路径是否暴露敏感流程,解密后是否长期驻留 | 明文位置、运行观察记录 |
| 关键逻辑 | 授权、解密等函数是否容易定位和理解 | 入口线索、调用关系分析 |
| 运行时保护 | 完整性校验、反调试和注入检测是否触发并响应 | 授权测试的触发与处置记录 |
| 性能影响 | 启动、热点函数和资源加载是否出现明显开销 | 同场景加固前后测试结果 |
| 服务端校验 | 奖励、付费权益等是否由服务端保留最终裁决权 | 接口校验规则与验证结果 |
符号和字符串适合做初筛,运行时能力仍要实测。so 加固做到哪一步,可以回到具体逻辑上判断:核心函数是否更难定位和理解,被修改后是否还有其他机制限制影响。这些结果比单看符号数量或反编译窗口是否难读,更有参考价值。